
Bei Kunden höre ich öfters den Satz: Selbst die kleinste Tabelle ist bei uns ein Datenprodukt, die kann man anklicken, abonnieren und verwenden. Das andere Ende kenne ich auch, ein ganzes Schema mit physischen Tabellen, das ohne weitere Beschreibung als Datenprodukt bereitgestellt wird. Beides läuft unter demselben Namen, und das zeigt ganz gut, wie unterschiedlich der Begriff verwendet wird.
Im Hub-Artikel zu dieser Serie habe ich die Frage schon gestellt: ein Star Schema fürs Accounting aus meiner Dimensional Modeling Fundamentals Class, mit Gegenbuchungen, einem Rechenmodell dahinter und Kostenverrechnung über mehrere Stufen, in Summe rund 15 Fakten- und Dimensionstabellen. Ist das ein Datenprodukt, sind es fünfzehn, oder ist es gar keins?
Die Antwort steht dort auch: eins. Die Begründung reicht aber weiter als die Antwort, denn sie sagt zugleich, was außer den 15 Tabellen noch zum Produkt gehört.
Eins, fünfzehn oder keins
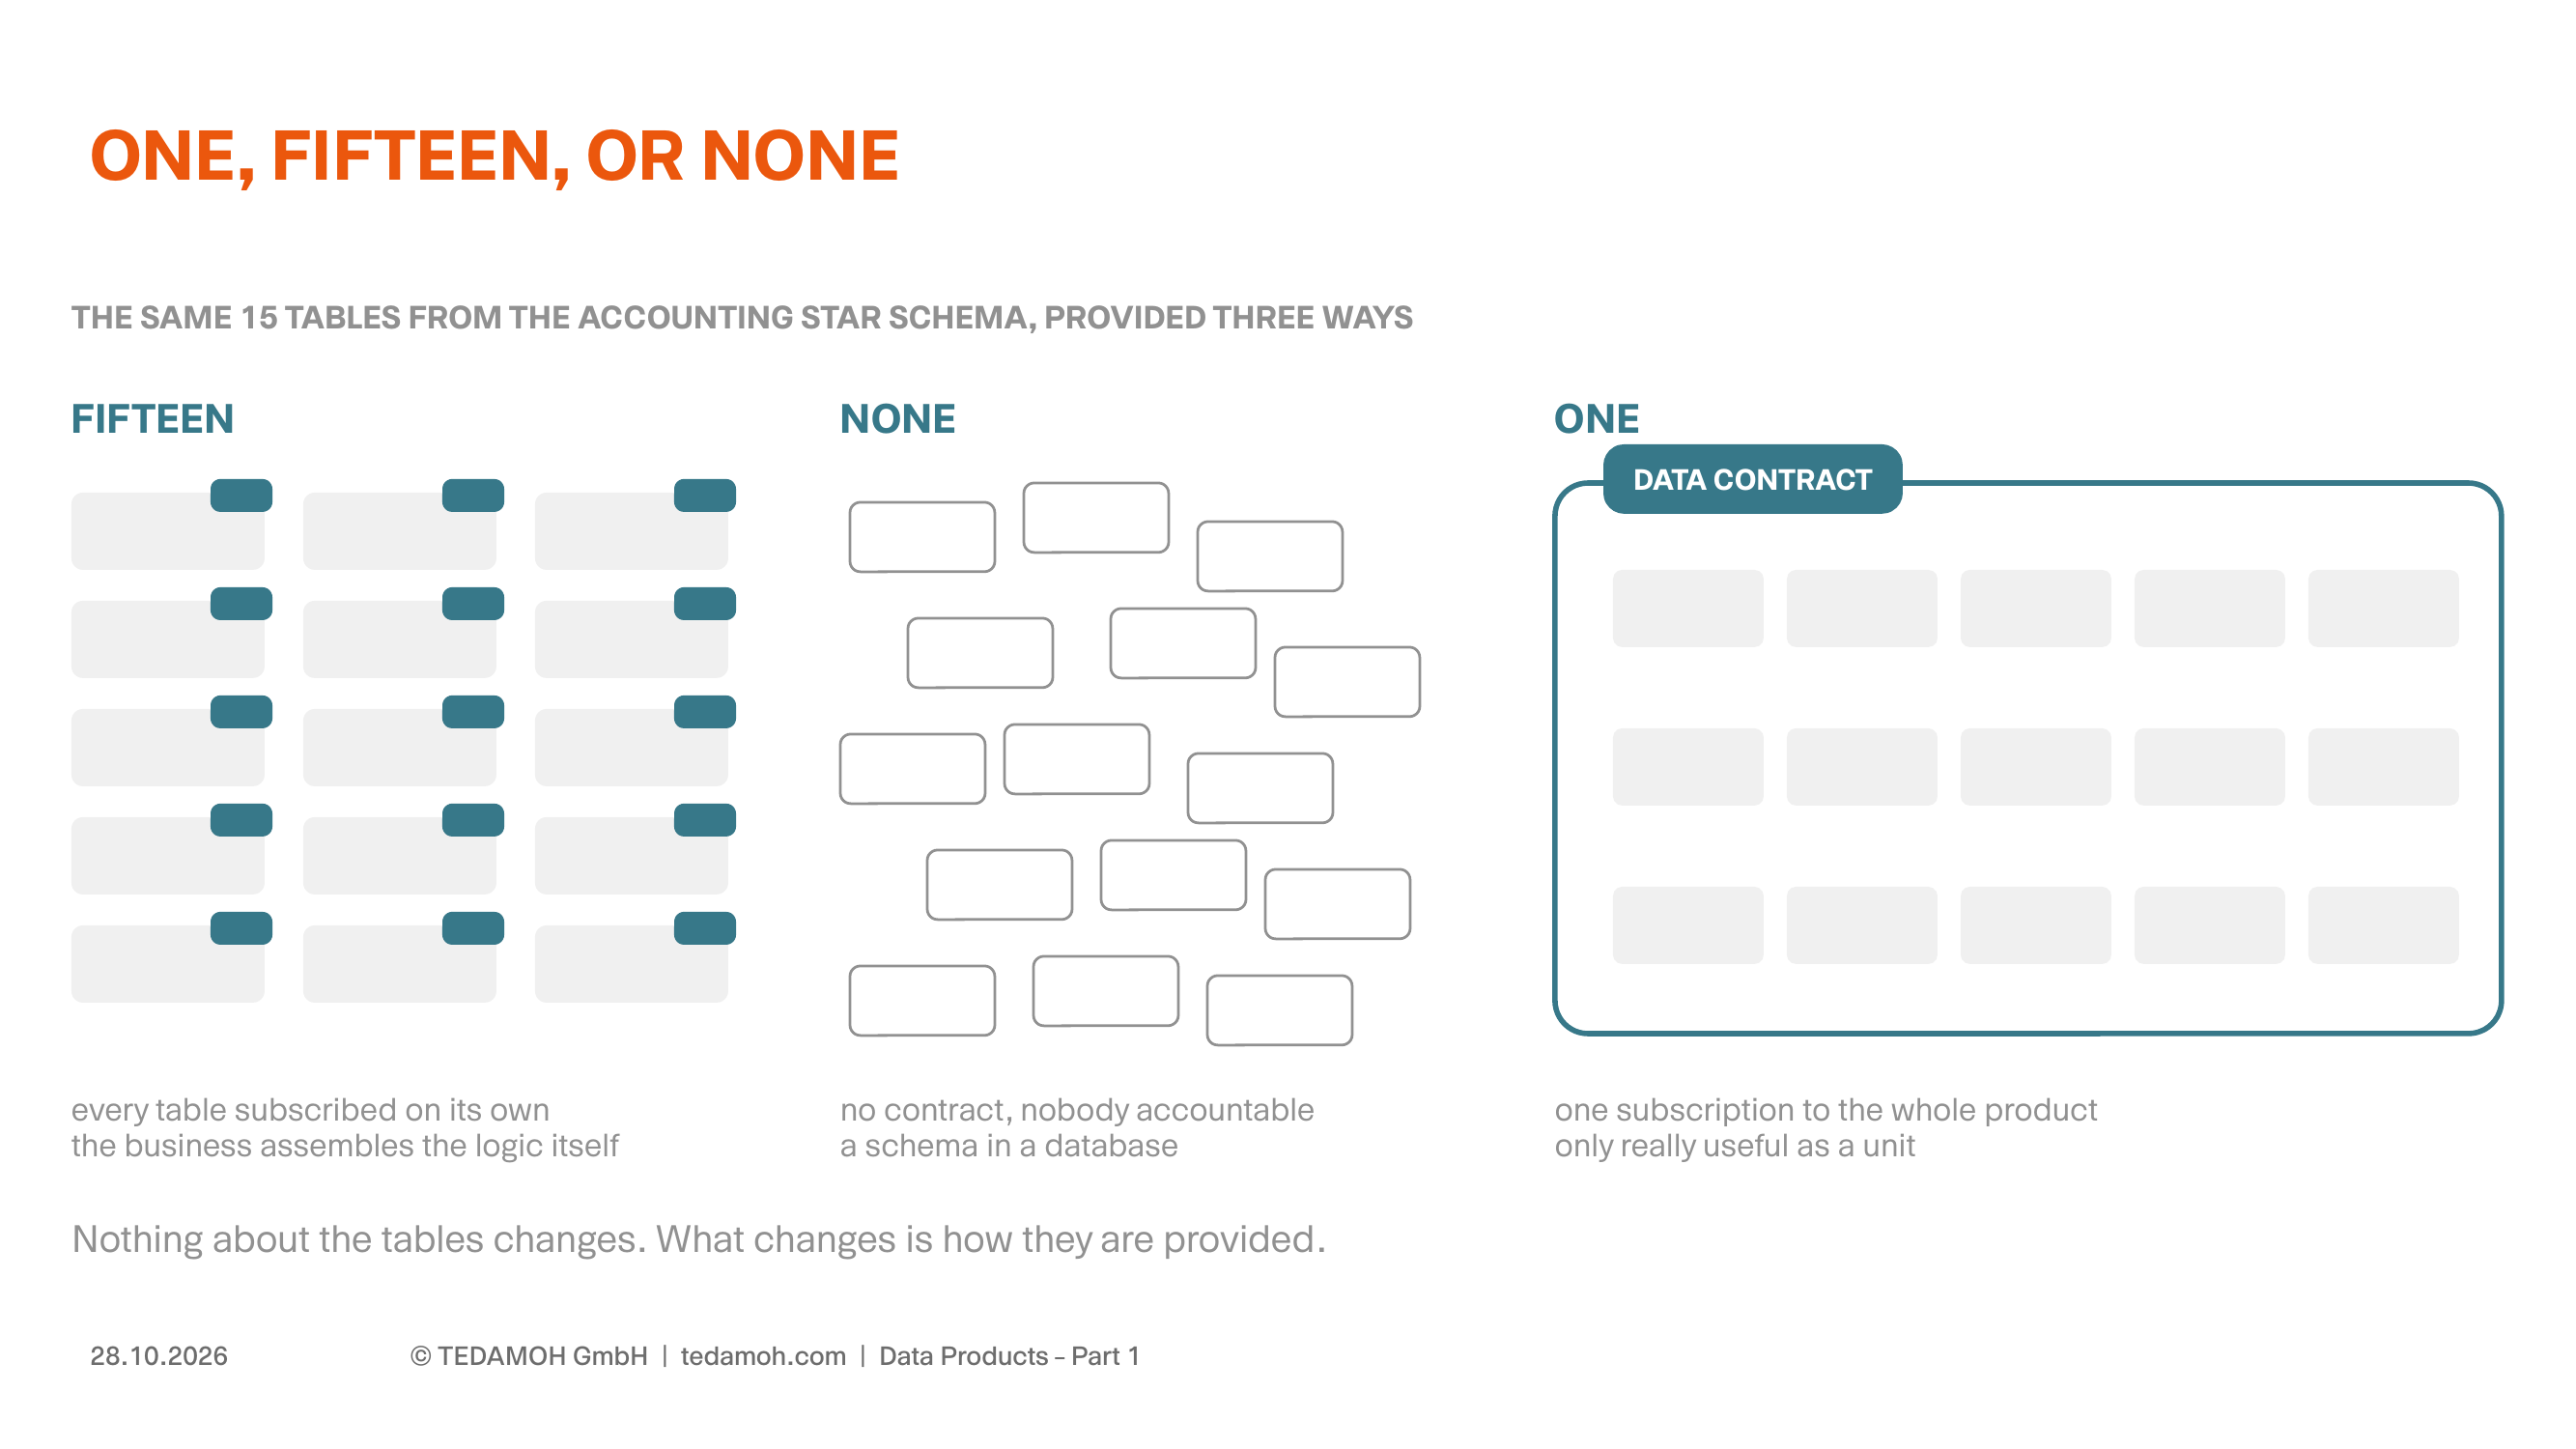
Dieselben 15 Tabellen, dreimal anders bereitgestellt.
Fünfzehn Datenprodukte hieße: Jede Tabelle lässt sich einzeln abonnieren, und wer im Accounting eine Auswertung braucht, setzt sich das Rechenwerk selbst zusammen. Wenn ich einem Fachbereich sage, such dir deine Sachen doch selbst zusammen, irgendwo in der Data Solution, dann höre ich ziemlich zuverlässig: nee, lass mal. OK, es gibt auch technik-affine Fachbereiche, die das gerne machen. Die Frage ist nur, warum. Aber das ist eine andere Geschichte. Aus der Nutzerperspektive möchte ich als Nutzer eines Star Schemas nicht erst noch selbst die zugehörigen Stammdaten suchen und joinen müssen.
Keins wäre die richtige Antwort, wenn die 15 Tabellen einfach in einer Datenbank liegen, ohne Contract und ohne jemanden, der für sie geradesteht. Das ist das Bild aus dem Hub, nur fünfzehnmal: Eine physische Tabelle ohne Beschreibung ist erst einmal nur eine Tabelle.
Bleibt eins. Wer ein Datenprodukt nutzt, möchte die Subscription auf das Produkt haben und nicht auf seine einzelnen Bestandteile. Für das Accounting-Star-Schema heißt das, alle 15 Tabellen stehen zusammen bereit, als eine Einheit, die man auch nur als Einheit sinnvoll nutzen kann.
Geschnitten wird vom Nutzer her
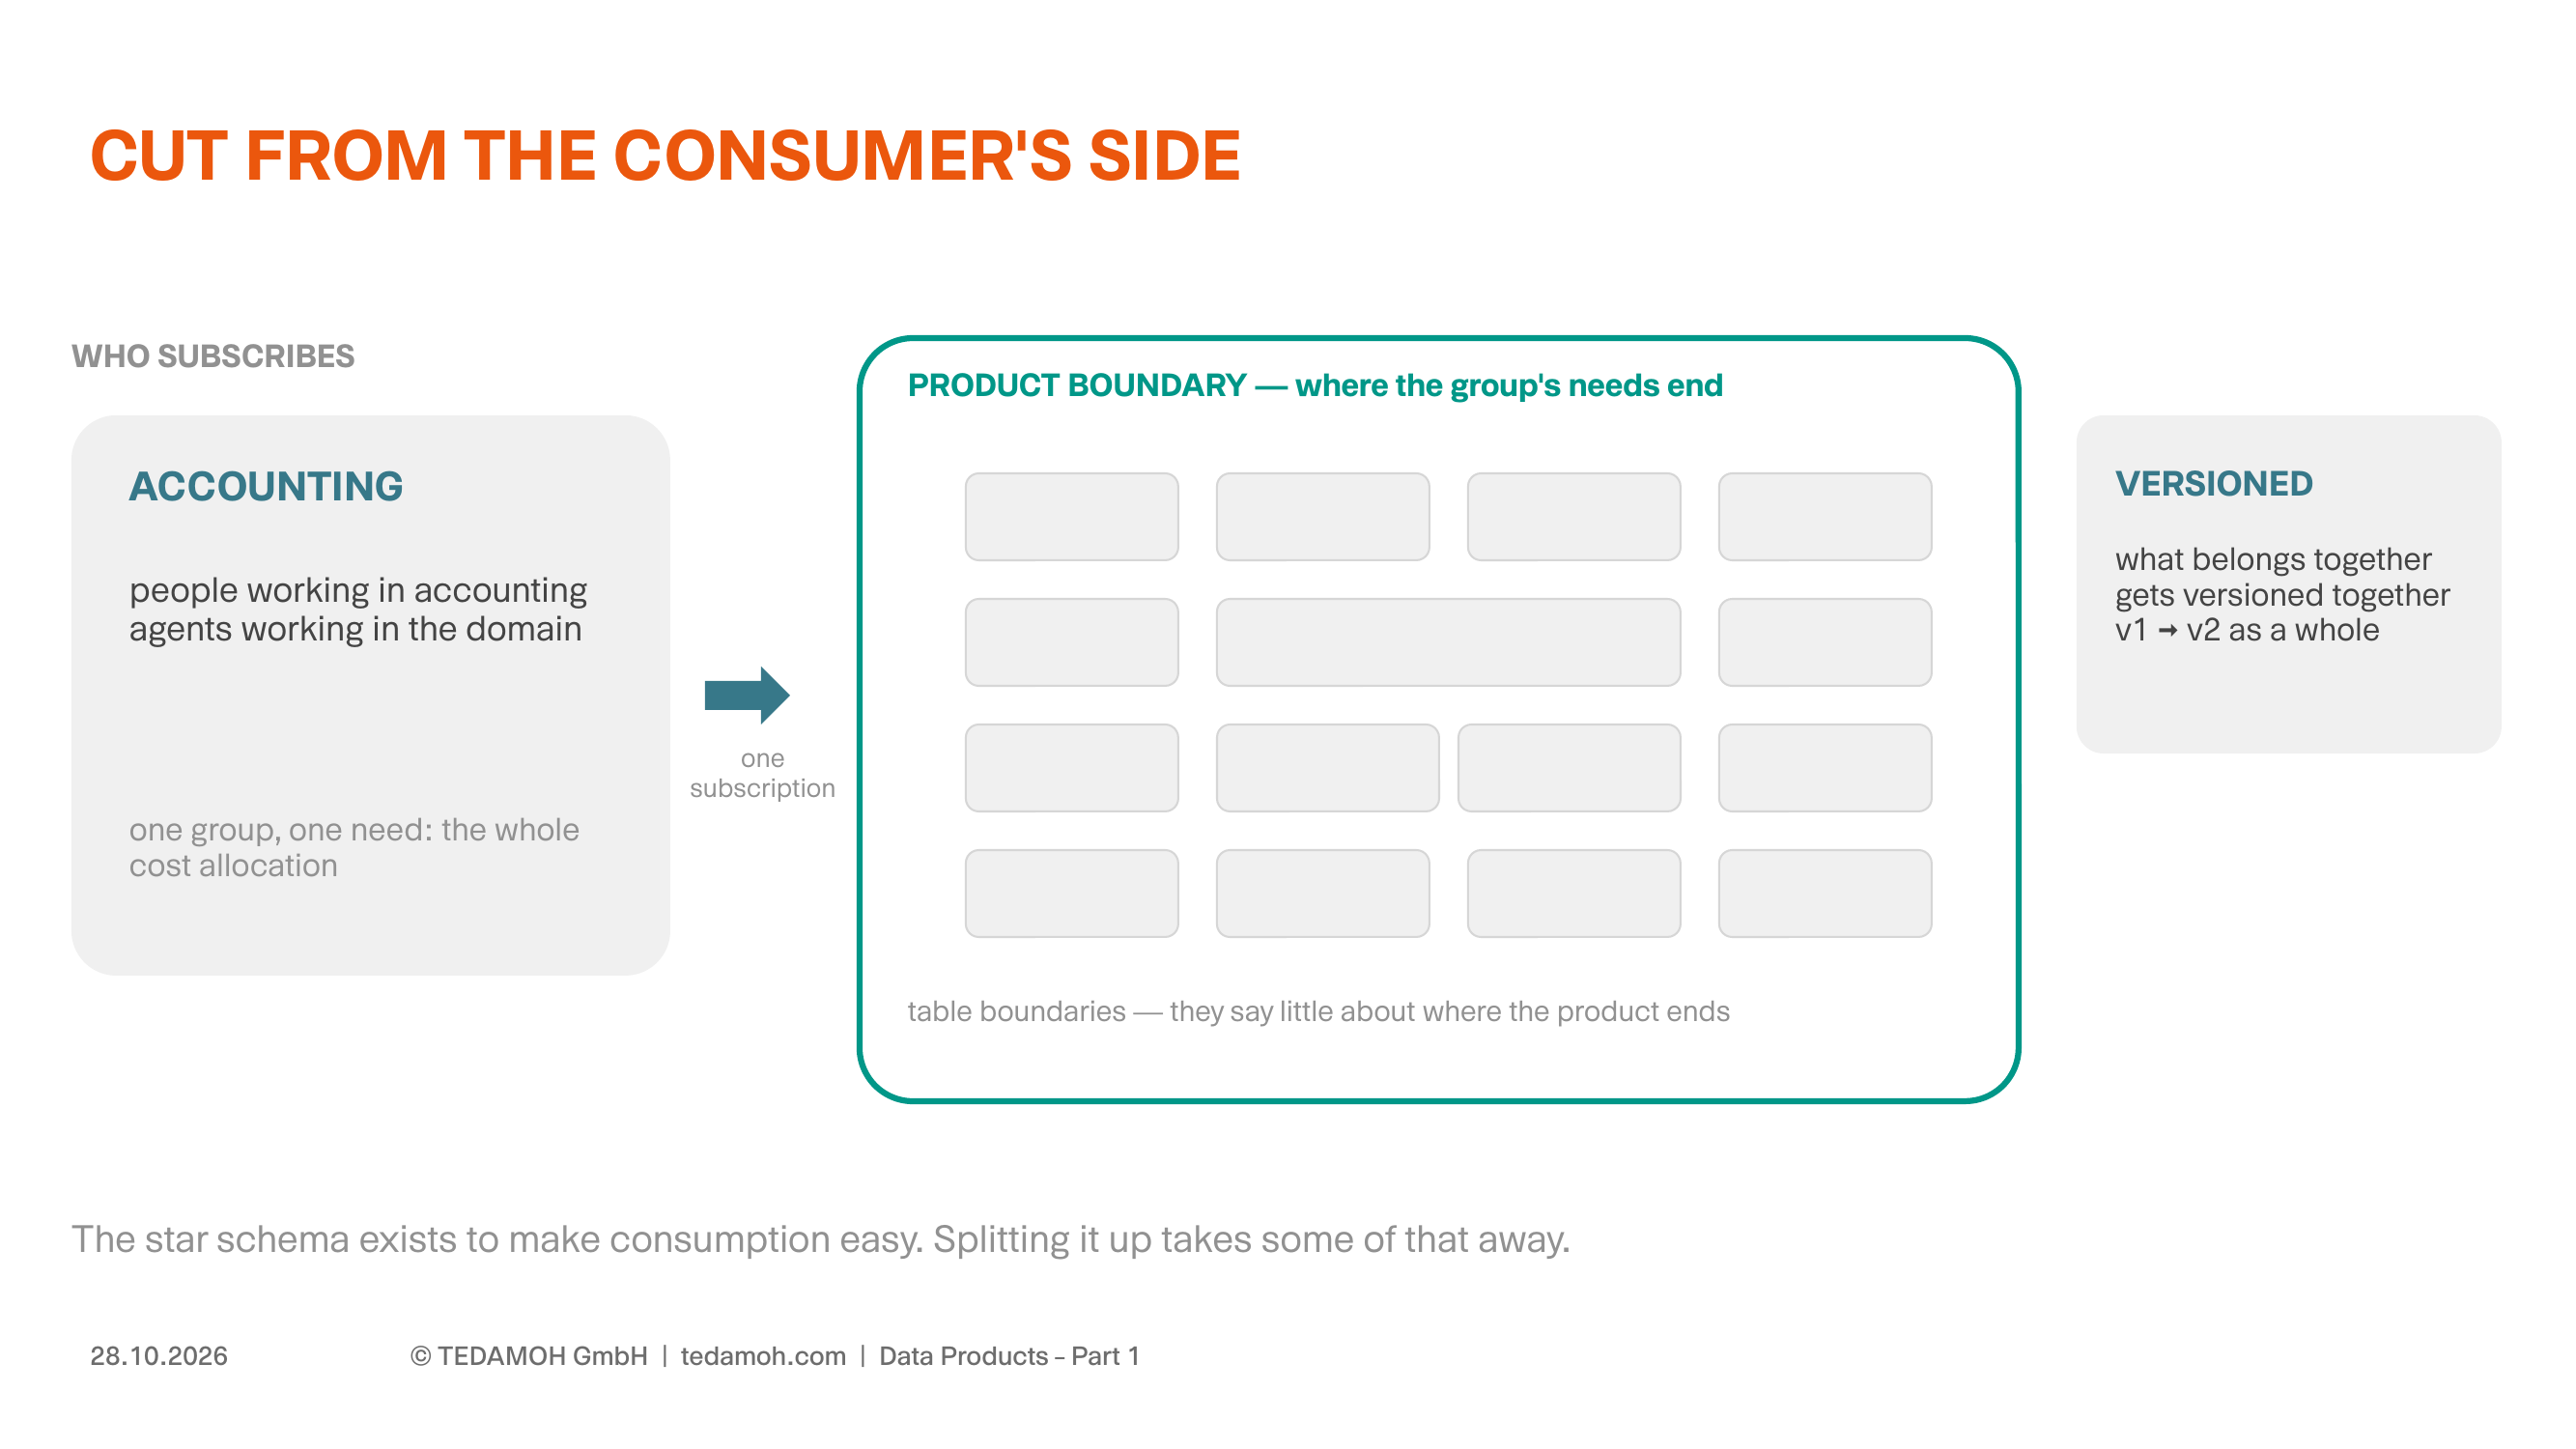
Die Grenze des Produkts folgt dem Bedarf seiner Nutzer.
Im Data Mesh heißt so ein Produkt consumer-aligned, also an seinen Nutzern ausgerichtet. Gebaut ist es für einen bestimmten Nutzungskreis: Menschen, vielleicht auch Agenten, die in der Accounting-Domäne arbeiten. Für diesen Kreis ist das Star Schema in sich abgeschlossen.
Aus Sicht der dimensionalen Modellierung liegt das ohnehin nahe. Ein Star Schema wird überhaupt erst gebaut, um den Konsum der Daten einfach zu machen. Wer es in fünfzehn einzeln abonnierbare Teile zerlegt, nimmt ihm einen Teil dieser Eigenschaft wieder weg. Dazu kommt die Wartung: Was zusammengehört, wird auch zusammen versioniert. So handhaben Roelant Vos und ich das auch in Data Engine Thinking. Die Grenze eines Datenprodukts liegt deshalb dort, wo der Bedarf eines Nutzungskreises endet; wo eine Tabelle aufhört, sagt darüber wenig. Wo genau diese Grenze verläuft, wenn es weniger eindeutig ist als im Accounting, ist das Thema von Teil 2.
Über diese Serie: Dies ist Teil 1 von 3 der Serie „Datenprodukte: Vom Modell zum Mehrwert“. Die Übersicht steht im Hub-Artikel. Teil 2 (18. November) zeigt, woher die Daten kommen und wie man ein Datenprodukt schneidet und bereitstellt. Teil 3 (9. Dezember) geht der Automatisierung durch Informationsmodelle nach.
Das Accounting-Star-Schema selbst modellieren
Genau dieses Star Schema mit seiner Kostenverrechnung über mehrere Stufen unterrichte ich in der Dimensional Modeling Fundamentals Class. Die DMFC ist jetzt als eLearning buchbar, die nächste Open Class läuft vom 31. Mai bis 11. Juni 2027.
Was neben der Schnittstelle dazugehört
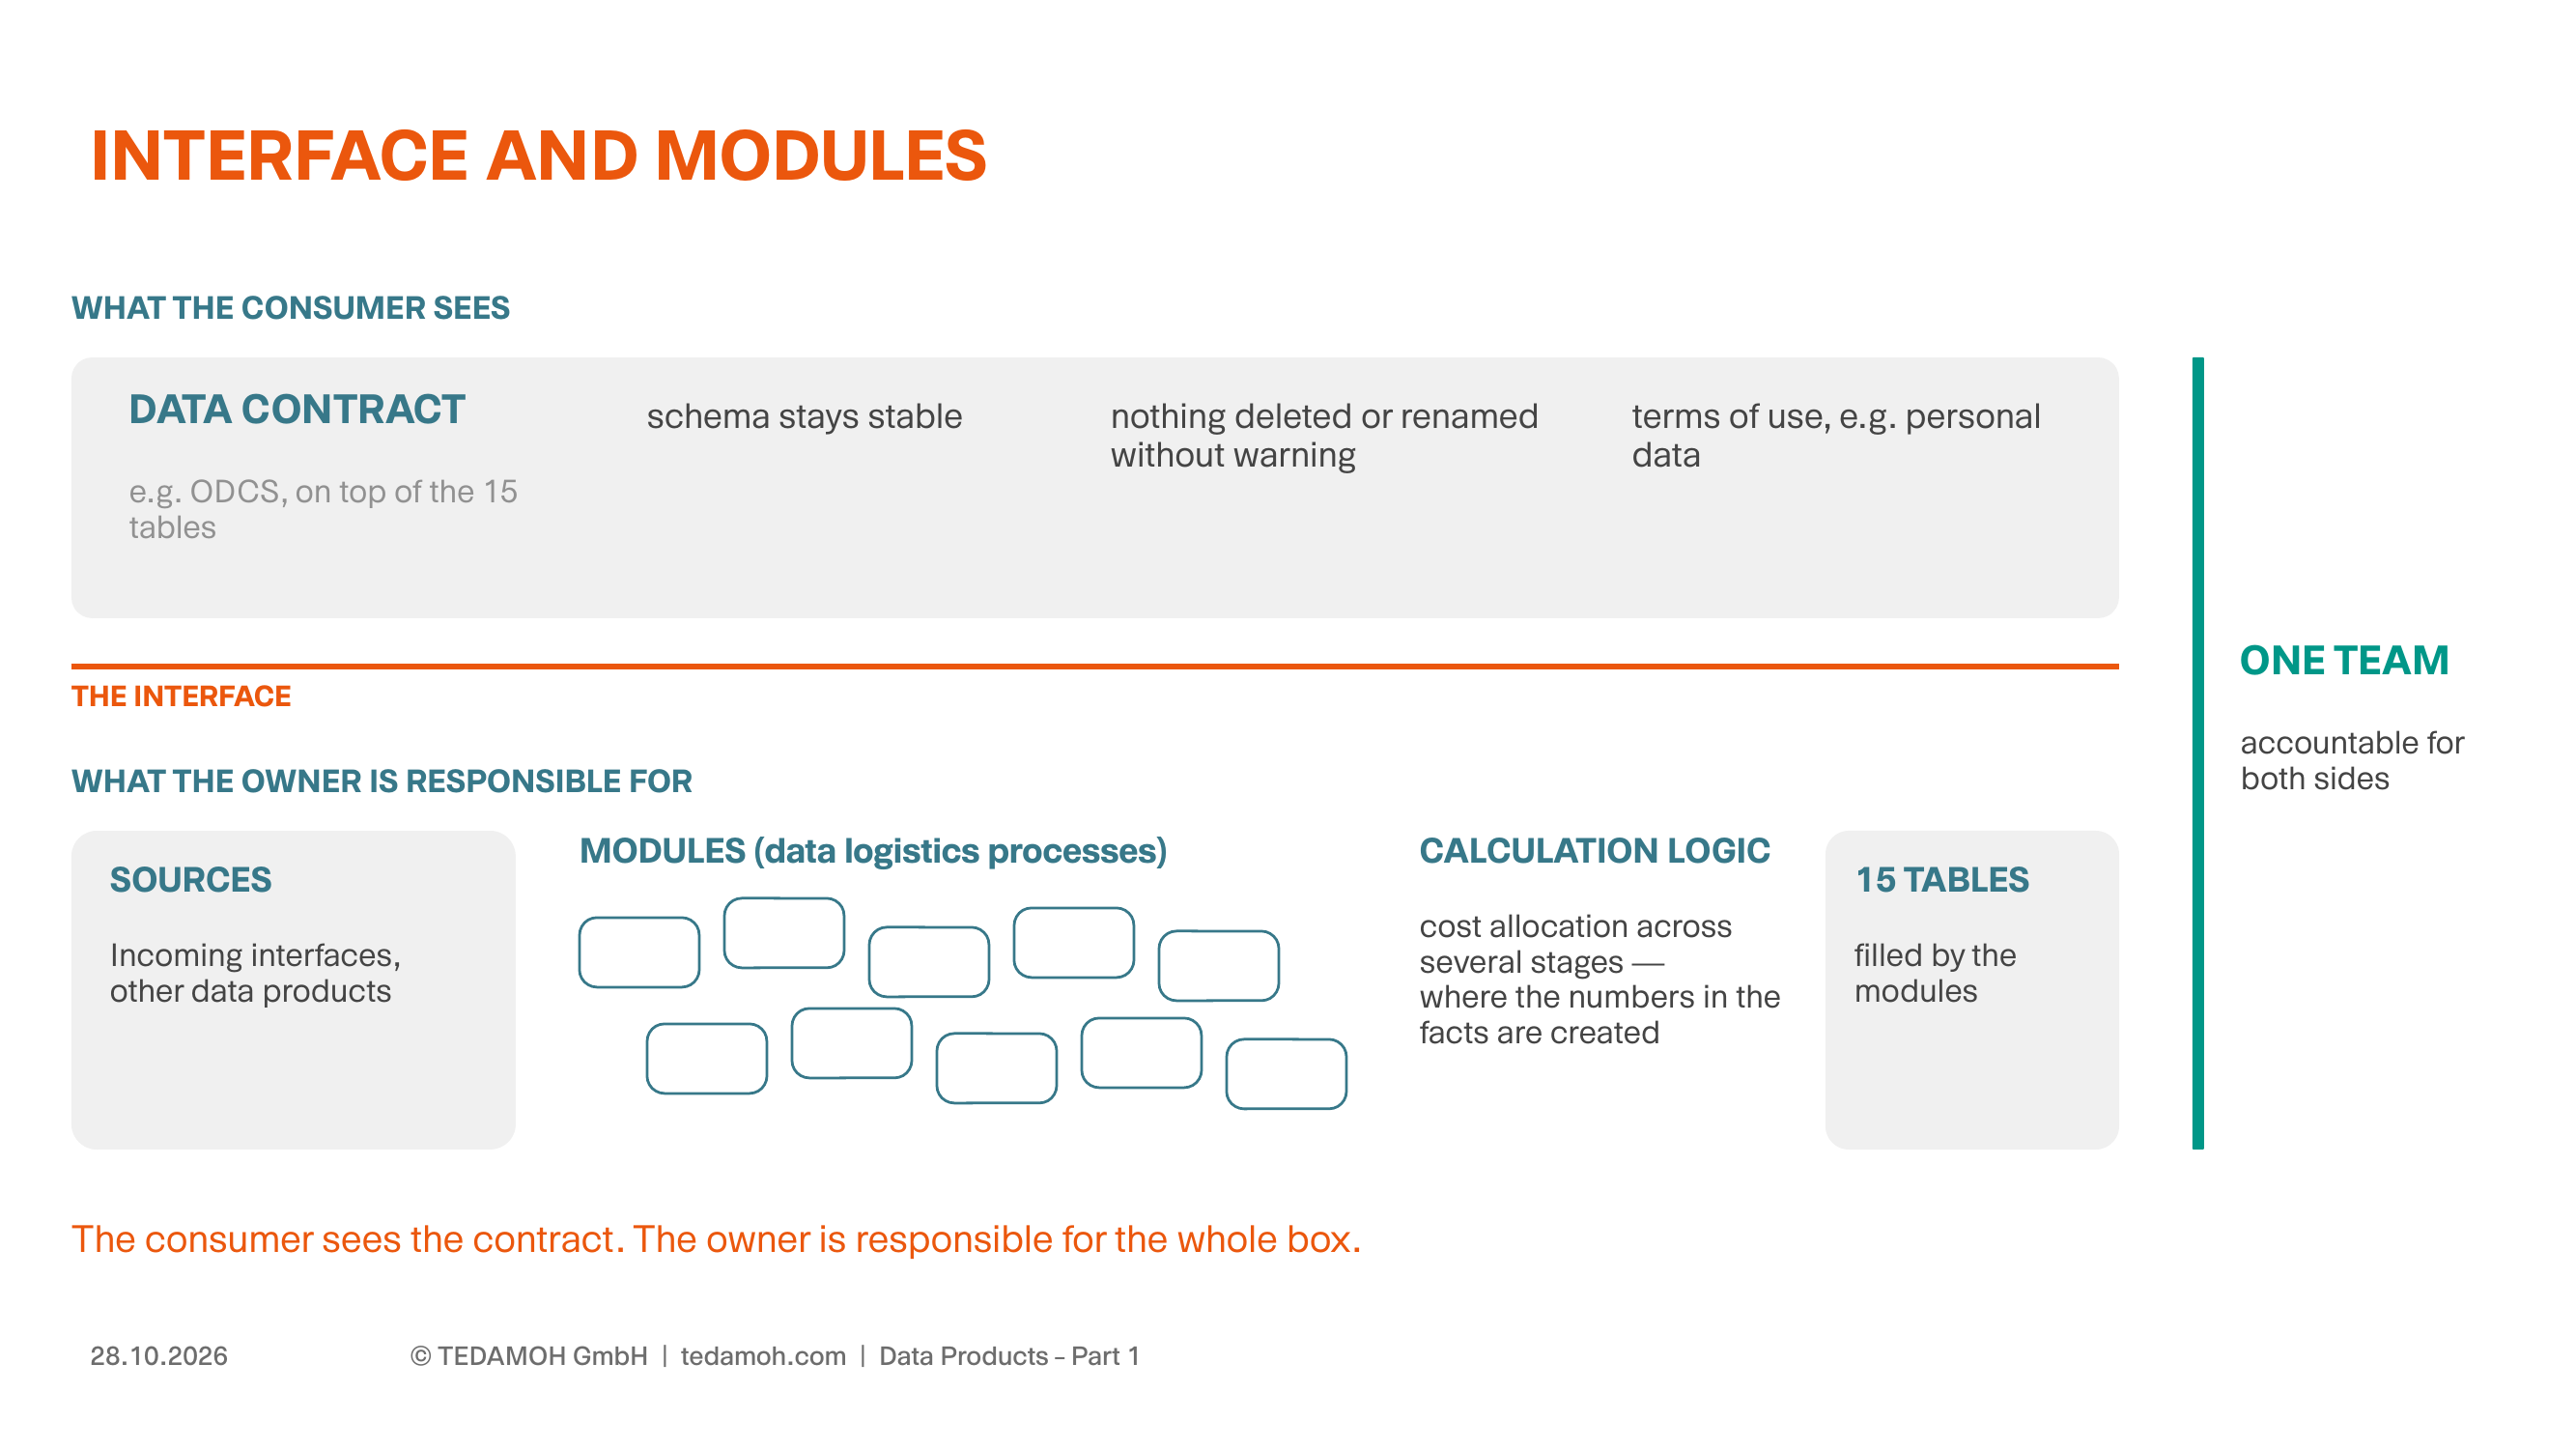
Der Nutzer sieht den Contract. Der Eigentümer verantwortet die ganze Box.
Ein Datenprodukt ist eine Art Box, und je nachdem, wer draufschaut, sieht man davon unterschiedlich viel.
Der Nutzer sieht die Schnittstelle, also die 15 Tabellen. Entscheidend ist für ihn der Data Contract, der darüber liegt, beschrieben zum Beispiel nach dem offenen Standard ODCS. Darin steht, worauf er sich verlassen kann: dass das Schema stabil bleibt, dass nichts einfach gelöscht oder umbenannt wird, und unter welchen Bedingungen er die Daten nutzen darf, etwa wenn personenbezogene Daten darin stecken.
Der Eigentümer sieht mehr. Zu seiner Box gehören die eingehenden Schnittstellen der Vorsysteme oder die anderen Datenprodukte, die sie nutzt, und die Module (Data-Logistik-Prozesse), die daraus die 15 Tabellen befüllen. Im Accounting ist das vor allem das Rechenwerk, also die ganze Kostenverrechnung über mehrere Stufen, mit der die Fakten befüllt werden. Für mich gehört es genauso zum Produkt wie die Tabellen, die am Ende herauskommen, denn die Zahlen in den Fakten entstehen erst dort. Schnittstelle und Module gehören deshalb zusammen.
Und dann braucht es jemanden, der für beides geradesteht. Ein Team verantwortet die Schnittstelle, die Qualität des Star Schemas und die Module dahinter. Ohne dieses Team hat die Box keinen Eigentümer, und übrig bleibt wieder ein Schema in einer Datenbank.
Beim Drive-in aus dem Hub ist das die Küche. Der Kunde sieht sie nicht und will sie meistens auch nicht sehen, aber jemand ist für sie verantwortlich. Und spätestens wenn einer doch die Details wissen will, muss es auf seine Frage eine Antwort geben.
Offen ist damit noch, woher die Daten kommen, die in die Box hineinfließen. Was, wenn es die Dimensionen Kunde oder Mitarbeiter schon gibt, weil jemand anders sie als Datenprodukt gebaut hat, und ich sie einfach wiederverwende? Darum geht es in Teil 2 am 18. November, zusammen mit der Frage, wo ein Datenprodukt aufhört und das nächste anfängt. Mehr dazu kommt in Folge #005 von [antifragile data], in der ich mit Simon Harrer über Datenprodukte spreche. Sie erscheint am 24. November.
So long,
Dirk
Quellen
Das Accounting-Star-Schema ist das Unterrichtsbeispiel aus der Dimensional Modeling Fundamentals Class.